Dentro la fabbrica: pre-training su scala e costi reali
Indice
- Non vince chi ha la GPU più veloce. Vince chi riesce ad accendere abbastanza megawatt in un solo posto.
- Dove eravamo rimasti
- Non un robot solo, ma un esercito di copie sincronizzate
- Scaling laws: la lezione di Chinchilla
- I dati non sono gratis: raccolta e pulizia
- Il cluster: quando l'unità di misura diventa il gigawatt
- La strategia low-cost: DeepSeek, FP8 e MLA
- Conclusioni
Non vince chi ha la GPU più veloce. Vince chi riesce ad accendere abbastanza megawatt in un solo posto.
Nei primi cinque articoli abbiamo smontato microgpt, il GPT in poche centinaia di righe di Karpathy: cos'è un LLM, come impara, come rappresenta il significato, come arriva alla risposta e infine quale modello scegliere tra cloud, open-weight e locale. Fin qui abbiamo sempre guardato il modello già pronto. Questo sesto numero fa un passo indietro: cosa succede prima, nella "fabbrica" dove quei pesi vengono prodotti? Perché un laboratorio spende centinaia di milioni di dollari per un modello, mentre un altro ottiene un risultato simile con una frazione di quella spesa?
I concetti che verranno introdotti in questo articolo sono i seguenti:
- Scaling laws (la relazione tra parametri, dati e calcolo e la lezione di Chinchilla)
- Data pipeline: raccolta, deduplicazione e filtraggio di trilioni di token, con un esempio concreto
- Cluster GPU su scala e il motivo per cui oggi il collo di bottiglia è l'energia, non il silicio
- Costi reali dei frontier lab, da GPT-4 ai modelli 2026
- La strategia low-cost di DeepSeek: FP8 e Multi-Head Latent Attention
Un CTO o un founder che integri l'IA nella propria azienda dovrà prima o poi rispondere a domande come queste:
- I prezzi delle API dei modelli che uso oggi sono destinati a scendere o a salire nei prossimi due anni?
- Se la mia azienda valuta di portare l'inferenza in locale invece di usare le API cloud, quanto incide davvero il costo dell'energia elettrica sul conto totale, oltre al prezzo della GPU?
- Se un fornitore mi propone un "modello addestrato da zero su misura per la mia azienda", è un'offerta credibile o è marketing travestito?
Procediamo a piccoli passi.
Dove eravamo rimasti
Con l'Articolo 5 (https://www.startupbusiness.it/inside-the-machine-5-quale-modello-cloud-open-weight-o-locale/180524/) abbiamo chiuso il ciclo pratico sul "quale modello": Cloud, Open-weight, Locale.
Infine abbiamo trattato il caso DS4 come dimostrazione che un modello quasi-frontiera può girare su un portatile.
Non abbiamo però mai guardato come avviene il passo precedente: il pre-training ossia il momento in cui un laboratorio decide di spendere centinaia di milioni di dollari per costruire un modello nuovo, partendo da zero. È lì che nascono i pesi che poi noi scarichiamo, affittiamo via API o quantizziamo per farli girare in locale.
Non un robot solo, ma un esercito di copie sincronizzate
Nell'Articolo 2 (https://www.startupbusiness.it/inside-the-machine-2-come-una-rete-neurale-impara/173509/) avevamo lasciato il modello nei panni di un gigantesco robot avvolto dalla nebbia: centinaia di miliardi di bulloni, i parametri, guidati dalla pendenza del terreno, il gradiente, verso il fondo valle, l'errore minimo. Quella immagine spiegava bene come impara il modello. Ma non diceva dove si trovasse fisicamente quel robot.
Ecco la risposta: dentro un edificio, non a cielo aperto. Un robot con centinaia di miliardi di bulloni è troppo grande per una singola macchina, e troppo lento se lavorasse da solo.
Serve una fabbrica intera piena di migliaia di GPU.
Le GPU si dividono il corpo del robot: ognuna si occupa di una piccola parte dei bulloni. Allo stesso tempo, centinaia di copie identiche del robot esplorano insieme porzioni diverse della stessa montagna, cioè i dati. Più volte al secondo si scambiano le loro misurazioni della pendenza, il gradiente, attraverso i cavi che corrono lungo i corridoi della fabbrica.
È come se dentro un unico capannone industriale ci fossero centinaia di migliaia di piccole "stanze della nebbia". Ognuna ha la sua copia del robot che scende, e tutte sono collegate via cavo a un centro che raccoglie le misurazioni e decide il prossimo passo, insieme.
Tutta questa fabbrica resta accesa giorno e notte, per mesi. E per restare accesa ha bisogno di una centrale elettrica dedicata.
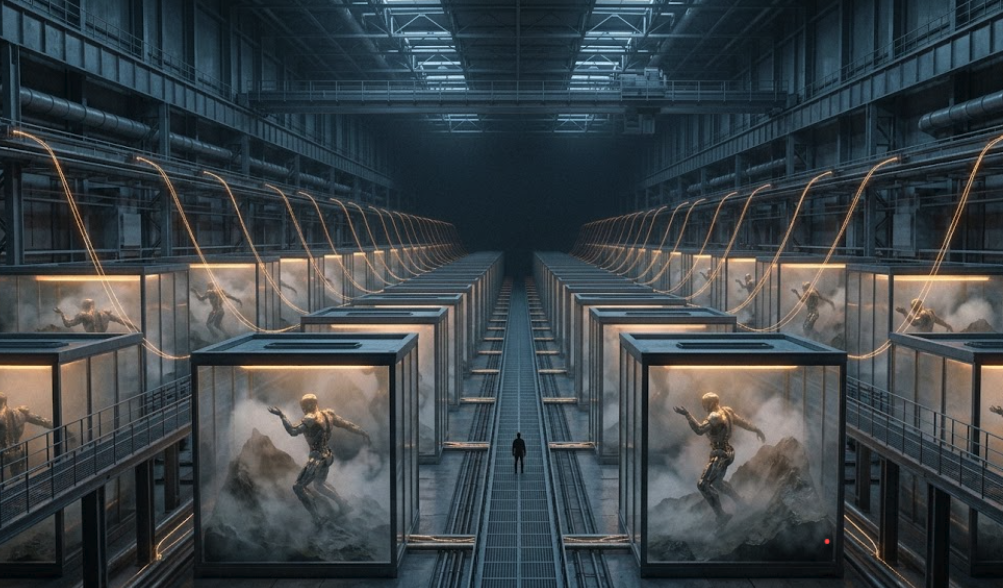
Figura 1: ogni GPU ospita una copia identica del robot che scende la propria montagna di dati, tutte sincronizzate tra loro da cavi che corrono lungo il capannone e alimentate da un'unica centrale elettrica.
Prima di accendere le linee di una fabbrica bisogna rispondere a tre domande.
- Quanti bulloni ha il robot, cioè quanti parametri? Nei modelli di frontiera, da qualche decina di miliardi a oltre un trilione.
- Quanta montagna di dati esplora, cioè quanti token? Trilioni, secondo il rapporto ottimale che spiega Chinchilla, tra un attimo.
- Quanta energia serve, cioè quanto calcolo in FLOPs? I modelli più avanzati superano i 10^25 FLOPs cumulativi.
Sbagliare uno solo di questi numeri vuol dire sprecare mesi e milioni di euro.
Scaling laws: la lezione di Chinchilla
Per anni la logica dei laboratori è stata semplice: più parametri, meglio è. Nel 2022 un team di DeepMind ha corretto questa idea con uno studio passato alla storia come "Chinchilla": molti modelli dell'epoca erano con un numero enorme di parametri, ma sotto-addestrati rispetto ai dati visti.
Per ogni parametro aggiunto serve una quantità proporzionale di token di addestramento altrimenti quel parametro resta "spento". Nel nostro esempio corrisponde ad un bullone stretto a caso e che nessuno regola più perché non c'è terreno su cui esercitarlo.
Un modello da 175 miliardi di parametri addestrato su pochi dati può essere superato da uno più piccolo ma addestrato su molti più dati.
Da qui in avanti la domanda non è più solo "quanto grande faccio il modello", ma "quanti dati di qualità ho per giustificare quella grandezza"
Lo studio di DeepMind ha dimostrato che per un addestramento computazionalmente ottimale il numero di token dovrebbe essere circa 20 volte superiore al numero di parametri (rapporto 1:20).
Di seguito un grafico prodotto dallo studio Chichilla.
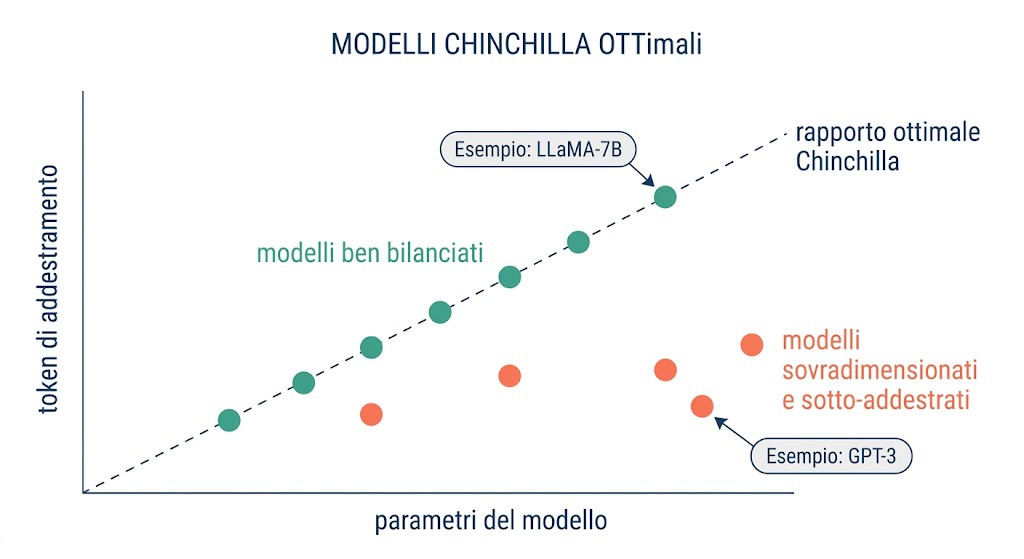
Figura 2: un grafico con la curva di Chinchilla che mostra la combinazione ottimale per un dato budget di calcolo (che influisce sul numero di token da usare) e numero di parametri. Da notare gli esempi di modelli "sovradimensionati" rispetto ai dati visti.
Come si nota nel grafico GPT-3 è considerato un modello sovradimensionato e sotto-addestrato (oversized, undertrained). GPT-3 è stato rilasciato nel 2020 con 175 miliardi di parametri ma è stato addestrato su soli 300 miliardi di token.
Applicando il rapporto proposto dallo studio di DeepMind, GPT-3 avrebbe dovuto essere addestrato su circa 3,5 mila miliardi di token (3,5 trilioni) per sfruttare appieno i suoi 175 miliardi di parametri. Come detto, è stato addestrato con appena 300 miliardi di token: un ordine di grandezza inferiore di quanto sarebbe servito. Un'enorme quantità di "bulloni" è rimasta di fatto inutilizzata.
I modelli moderni (vedi LLaMA) hanno invertito questa tendenza: invece di aumentare i parametri, usano architetture più compatte ma le addestrano su volumi enormi di dati ottenendo prestazioni superiori a GPT-3 con meno memoria.
I dati non sono gratis: raccolta e pulizia
Si parla sempre di quanti trilioni di token che un modello ha "visto", non si parla del lavoro necessario per arrivare ai trilioni di token puliti.
Di seguito vengono spiegati i passi necessari per generare i token utili puliti per l’addestramento.
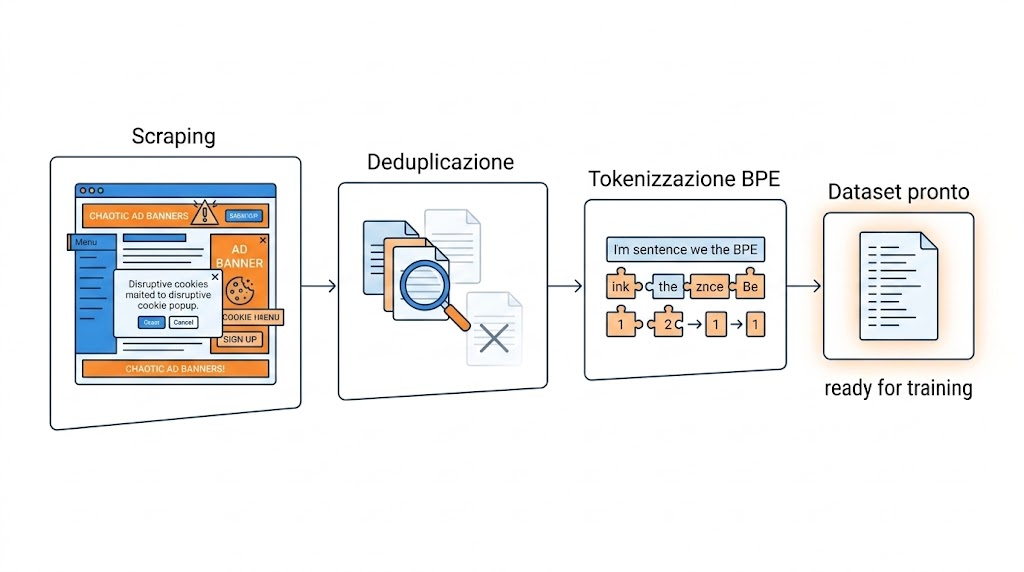
Figura 3: le quattro fasi della pipeline dati, dallo scraping del web ai dati puliti pronti per il tokenizer.
Passo 1. Scraping
La materia prima arriva da Common Crawl, un archivio pubblico di miliardi di pagine web raschiate ogni mese, con tutto il loro contorno: menu, cookie banner, footer ripetuti su ogni pagina dello stesso sito.
Immaginiamo una pagina ottenuta dallo scraping da un blog di ricette:
<html><body>
  <nav>Home | Ricette | Chi siamo | Contatti</nav>
  <div class="cookie-banner">Questo sito utilizza cookie...</div>
  <article>
    <h1>mpurnato</h1>
    <p>Timballo di pasta: ziti conditi con ragù di maiale,
     finocchietto selvatico, cavolfiore, uova e pecorino, passato in forno.</p>
  </article>
  <footer>© 2026 Tutti i diritti riservati.</footer>
</body></html>
Utilizzando strumenti come la libreria Python "Trafilatura", i tag nav, i banner dei cookie e i footer spariscono da una pagina HTML, lasciando solo il contenuto utile: "mpurnato. Timballo di pasta: ziti conditi con ragù di maiale, finocchietto selvatico, cavolfiore, uova e pecorino, passato in forno."
Anche se la quantità di dati si è ridotta eliminando il "rumore", la ridondanza è appena iniziata. Immaginiamo ad un blog di cinquecento pagine: se tutte condividono lo stesso footer, quel footer comparirà identico cinquecento volte. Questo avviene spessissimo su milioni di siti. Il risultato quale è? Che vi saranno miliardi di token duplicati che non insegnano nulla al modello.
Per risolvere questo problema ci viene in aiuto la “deduplicazione”.
Passo 2. Deduplicazione
Adesso bisogna lavorare su due livelli.
La deduplicazione esatta scarta i doppioni identici confrontando un hash del testo (una specie di impronta digitale): se due pagine hanno lo stesso identico corpo, se ne tiene una sola.
La deduplicazione approssimata (near-duplicate) individua invece pagine simili ma non uguali, con l'indice di Jaccard il quale misura quanto due insiemi si assomigliano.
Prendiamo due varianti di una ricetta di patate:
- Versione A: "le patate assazzunate sono patate lesse condite con olio, origano e cipolla"
- Versione B: "le patate assazzunate sono patate bollite condite con olio, origano e cipolla tritata"
Come si nota ci sono due parole cambiate, il resto è identico.
L'indice di Jaccard tra le due viene 0,55: abbastanza simile da scartarne una. A scala di trilioni di documenti, confrontare ogni possibile coppia di testi uno per uno sarebbe impossibile: le coppie da controllare crescerebbero troppo in fretta. Per questo si usano tecniche che stimano la somiglianza in modo molto più rapido, senza dover confrontare tutto con tutto.
Passo 3. Tokenizzazione BPE
A questo punto entra in gioco il tokenizer BPE dell'Articolo 1: il testo pulito viene spezzato in pezzi, ogni pezzo diventa un numero. Le parole comuni restano intere, quelle rare vengono spezzate. Sulla nostra frase pulita, il risultato assomiglierebbe a questo:
['m] [purn] [ato] [.] [Timballo] [di] [pasta] [:] [ziti] [conditi] [con] [ragù] [di] [maiale] [,] [finocchietto] [selv] [atico] [e] [pecorino] [,] [passato] [in] [forno] [.]
"Di", "con", "e" restano token unici perché frequentissimi. "'mpurnato" e "selvatico", parole rare nel dataset di addestramento, vengono invece spezzate in più pezzi. Contando i token su tutta la pagina: la versione grezza, con nav, cookie banner e footer, ne produce 105; la versione pulita, solo corpo dell'articolo, appena 36. Più del 65% del corpus grezzo era puro rumore ripetuto, non contenuto.
Passo 4. Dataset pronto: chiudiamo il cerchio con microgpt
Il file di Karpathy legge un dataset già pronto di 32.000 nomi propri, uno per riga, tokenizzandoli carattere per carattere. Non deve fare scraping né deduplicazione: Karpathy ha già risolto il problema a monte scegliendo un dataset piccolo e pulito.
Per capire cosa vuol dire "dataset già pronto", proviamo a immaginare cosa servirebbe per insegnare a microgpt i nomi di ricette invece che nomi di persona. Il file di addestramento dovrebbe avere questo aspetto, una voce per riga, senza HTML, senza footer, senza doppioni:
mpurnato
ragu
macco
caponata
arancino
Ogni riga viene poi racchiusa tra due copie del token speciale di inizio/fine sequenza, il BOS dell'Articolo 4, e spezzata carattere per carattere. Per "mpurnato" il modello vedrebbe questa sequenza:
[BOS] [m] [p] [u] [r] [n] [a] [t] [o] [BOS]
Ecco perché microgpt salta i primi due passi (scraping e deduplicazione), qualcuno li ha già fatti in precedenza.
Il terzo passo ossia la tokenizzazione resta, ma nella sua forma più semplice possibile.
Il ciclo di addestramento che segue (calcolo della loss, gradiente, backpropagation) è identico in entrambi i casi: sia che il dataset con 32.000 righe ripulite a mano, sia che abbia quindici trilioni di token ottenuti da scraping industriale. Cambia solo cosa succede prima di premere "avvia il training": in microgpt quel lavoro l'ha già fatto Karpathy; per un modello di frontiera, la raccolta e la pulizia dei dati avvengono dentro la fabbrica, ed è l'operazione più costosa e meno raccontata di tutto il processo.
Il cluster: quando l'unità di misura diventa il gigawatt
Addestrare un modello di frontiera oggi vuol dire collegare in tempo reale decine o centinaia di migliaia di GPU che si scambiano continuamente risultati parziali (i gradienti). Per dare un'idea delle proporzioni raggiunte a metà 2026: i cluster più grandi al mondo oggi superano il mezzo milione di GPU in un singolo sito e assorbono una potenza nell'ordine del gigawatt, l'equivalente del fabbisogno elettrico di una città di medie dimensioni. In futuro i cluster cresceranno ancora.
Ad un certo punto della crescita il punto importante smette di essere "quante GPU riesco a comprare" ma diventa "quanti megawatt riesco ad accendere in un solo posto, entro i tempi della costruzione". Comprare una GPU si fa in giorni, creare una centrale o espanderla richiede mesi o anche anni.
Stima dei costi di un modello di frontiera
Le cifre sui costi di training sono stime basate su dichiarazioni informali quindi dati da prendere “con le pinze”. Dalle dichiarazioni di Altamn, GPT-4, si parla di 80-100 milioni di dollari solo per il costo di calcolo del training finale, senza tener conto di stipendi, run falliti e raccolta dati.
A metà 2026 i training run dei modelli più avanzati costano tra alcune centinaia di milioni e oltre un miliardo di dollari: un ordine di grandezza in più rispetto a GPT-4.
La strategia low-cost: DeepSeek, FP8 e MLA
DeepSeek ha sbalordito la la comunità in maniera dirompente dimostrando che si può fare con costi nettamente inferiori.Per il modello DeepSeek V3, il laboratorio che lo ha sviluppato dichiara un nell'ordine di 5,5-6 milioni di dollari, creando un modello con una qualità paragonabile ai modelli occidentali, costati decine o centinaia di volte tanto.Questa cifra riguarda solo l’addestramento e non l'intero costo di ricerca e sviluppo del laboratorio.
Il divario di efficienza comunque rimane: si può ottenere un risultato quasi altrettanto buono, con una frazione del budget, utilizzando nuove idee e nuovi tecniche più furbe.
Il merito della riduzione dei costi è dovuta a tre tecniche usate insieme:
- il Mixture of Experts (MoE) che divide il modello in tanti sotto-modelli specializzati detti "esperti", già visto nell'Articolo 5
- La Multi-Head Latent Attention (MLA) che comprime i vettori Key e Value della KV cache (Articolo 4) in una forma più compatta, liberando memoria GPU per gestire sequenze più lunghe o più richieste in parallelo.
- Il training in FP8 che riduce da 16 a 8 bit la precisione con cui vengono rappresentati i numeri, dimezzando memoria e tempo di calcolo. Il prezzo da pagare è un rischio tecnico da gestire, l'underflow: i valori più piccoli del gradiente rischiano di azzerarsi.
La somma di MLA, FP8 e MoE riduce i costi di fabbrica di un fattore 50 o addirittura 100.
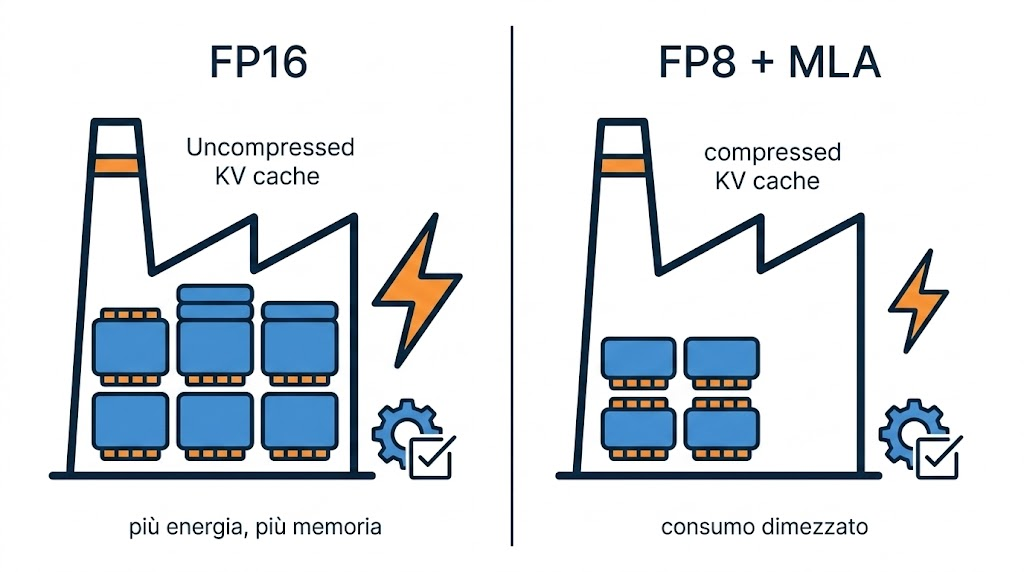
Figura x: confronto tra due "fabbriche". A sinistra un impianto in FP16 con KV cache non compressa: più energia, più memoria. A destra lo stesso lavoro in FP8 con MLA: stessa produzione, consumo dimezzato.
Conclusioni
Il pre-training di un modello di frontiera non è un unico numero ma un sistema di vincoli che si tengono a vicenda: quanti dati puliti hai, quanto calcolo puoi permetterti, quanta energia riesci ad accendere in un solo sito, quanto sei disposto a investire in ingegneria. Soprattutto quanto sei avanti nelle ricerche e stratagemmi (vedi le tecniche usate da Deepseek).
Hint 1 — Diffida di chi vende training da zero come soluzione aziendale
Nell'Hint dell'Articolo 2 (https://www.startupbusiness.it/inside-the-machine-2-come-una-rete-neurale-impara/173509/) dicevamo che il 99% delle aziende non deve addestrare nulla da zero. Dopo le cifre appena citate quella percentuale sale quasi al 100%: centinaia di milioni di dollari.Se un fornitore vi propone di addestrare un modello di frontiera da zero per voi, con ogni probabilità è un fine-tuning, quello da poche migliaia di euro rivenduto col linguaggio di marketing suggestivo del "training da zero".
Hint 2 — Le tecniche di risparmio di DeepSeek sono le stesse che permettono l'uso locale
Se un fornitore vi vende un modello come "leggero", chiedetegli semplicemente quale tecnica usa: MoE, quantizzazione, compressione della memoria. Sono le stesse idee che permettono a un laboratorio di risparmiare in fase di training, e le stesse che permettono a voi di far girare un modello sul vostro hardware. Se il fornitore non sa rispondere, quel modello probabilmente non è stato progettato per essere leggero: qualcuno lo ha solo compresso in fretta e senza criterio, dopo che era già pronto.
Nel prossimo numero torniamo sull'allineamento: come funziona davvero PPO, il meccanismo che tiene a freno l'RLHF, e perché quel vincolo impedisce al modello di "esagerare" nel cercare di piacere ai valutatori.